Як писати статті, які цитує AI-пошук: що відрізняє їх від звичайних SEO-текстів
Наталія Іванченко12 хв читання2 242 слів
Коротко
Статтю, яку цитує AI-пошук, відрізняє не спеціальний стиль, а те, що з неї можна взяти один абзац, і він лишиться правильною відповіддю без решти сторінки. Для цього відповідь на запит стоїть у перших двох абзацах, терміни визначені окремим реченням «X це Y», порівняння зведені в таблиці, а кожне число має формулу, період і джерело. Google прямо пише, що переписувати тексти спеціально під AI не потрібно, а llms.txt і дрібне нарізання тексту Google відносить до речей, які для Google Search можна ігнорувати. Цитування тримається на тому самому фундаменті, що й ранжування: сторінка має бути в індексі, доступна для сніпета і відкрита для пошукових роботів ChatGPT і Perplexity, якщо ви хочете бути в їхніх відповідях.
Статтю, яку цитує AI-пошук, відрізняє від звичайного SEO-тексту не спеціальний прийом, а те, що з неї можна взяти один абзац, і він лишиться правильною відповіддю без решти сторінки. Для цього відповідь на запит стоїть у перших двох абзацах, терміни визначені окремим реченням «X це Y», порівняння зведені в таблиці, а кожне число має формулу, період і джерело. Окремого «AI-стилю» немає: Google у посібнику з оптимізації під генеративні функції пошуку прямо пише, що переписувати тексти спеціально під AI не потрібно, а llms.txt, нарізання тексту на дрібні шматки і погоню за неавтентичними згадками відносить до речей, які для Google Search можна ігнорувати. Класичні правила SEO-тексту розібрано в матеріалі SEO-копірайтинг: що це.
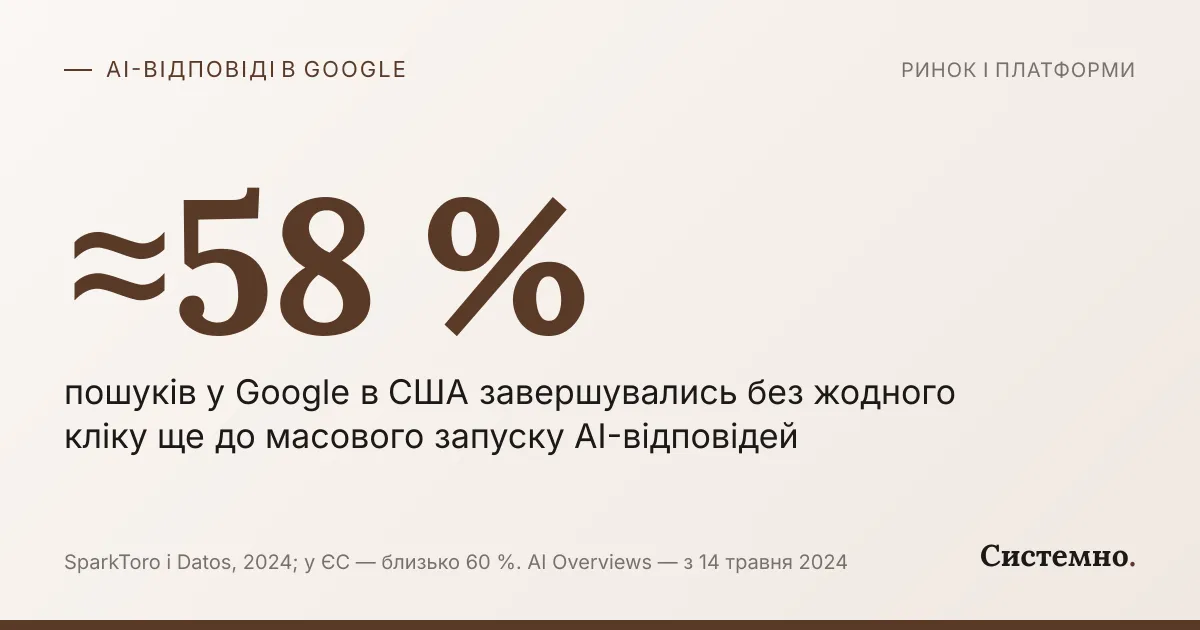
Цитування тримається на тому самому фундаменті, що й ранжування. AI Overviews і AI Mode беруть сторінки з індексу Google через основні системи ранжування, тому сторінка, яка не індексується або не може показуватись зі сніпетом, джерелом не стане, хоч як добре її написати. У ChatGPT і Perplexity є власні пошукові роботи, і OpenAI та Perplexity у документації радять дозволити їх у robots.txt, якщо сайт має зʼявлятися у відповідях. Статті про індексацію, семантику і технічний стан сайту зібрані в темі «Сайт і SEO», а як AI-відповіді змінили трафік, розібрано в статті про AI-відповіді в пошуку Google.
Чим цитування відрізняється від ранжування
Ранжування це місце сторінки у списку результатів за запитом. Цитування це посилання на сторінку як на джерело конкретного твердження всередині згенерованої відповіді. Ранжування оцінює сторінку як відповідь на запит, а для цитування потрібен фрагмент, який підтверджує конкретне речення відповіді. Тому сторінка з восьмого місця може стати джерелом, а сторінка з першого може в джерела не потрапити.
Google описує механіку двома термінами. RAG, або grounding, це спосіб, яким модель спирається на знайдені в індексі сторінки, щоб відповідь була точною і свіжою. Query fan-out це набір повʼязаних підзапитів, які модель запускає паралельно із запитом людини, щоб зібрати більше матеріалу. Умовний приклад: на запит «як порахувати CAC» підзапитами можуть бути «CAC формула», «співвідношення LTV до CAC», «CAC для малого бізнесу». Ваша стаття може не ранжуватись за головним запитом, але найкраще відповідати на один із підзапитів, і тоді потрапити у відповідь саме через нього.
| Ранжування | Цитування | |
|---|---|---|
| Що оцінюється | сторінка за запитом | фрагмент під одне твердження |
| За що конкуруєте | головний запит | головний запит і підзапити fan-out |
| Де видно в Search Console | звіт «Ефективність»: кліки, покази, позиція | звіт Generative AI performance: покази в AI Overviews і AI Mode |
| Що дає бізнесу | перехід на сайт | згадку і видимість, переходів мало |
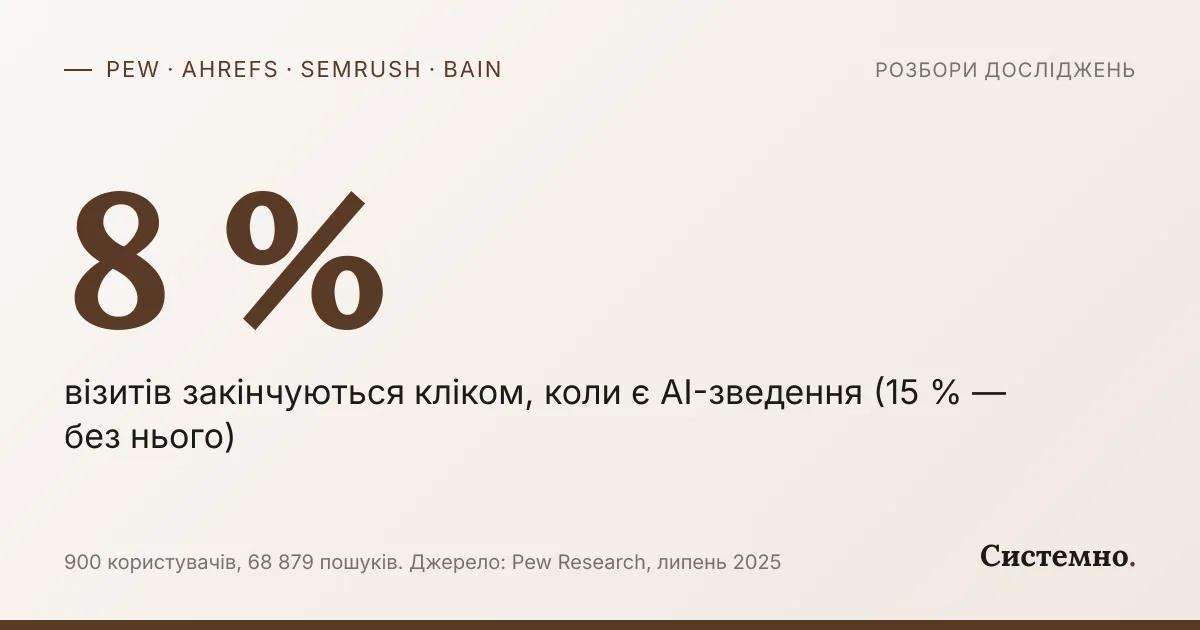
Останній рядок таблиці спирається на дані Pew Research Center: у березні 2025 року 900 дорослих у США дали доступ до своєї активності в браузері, і на посилання всередині AI-зведення клікали лише в 1 % візитів на сторінки з таким зведенням. У тому ж дослідженні 88 % зведень мали три і більше джерел, а медіанна довжина зведення була 67 слів. Грубий підрахунок: 67 слів медіанного зведення, поділені на три джерела, дають близько 22 слів на кожне, тобто одне речення. Шанс має те речення, яке можна взяти без контексту. Як інші дослідження оцінюють втрату кліків, зведено в порівнянні чотирьох досліджень про AI Overviews.
Лабораторне дослідження GEO (Аґґарвал і співавтори, конференція KDD 2024) показало ту саму розбіжність між місцем і цитуванням. Коли в текст додавали посилання на джерела, видимість у згенерованих відповідях для сторінок із пʼятого місця видачі зросла на 115 %, а для сторінок з першого впала на 30 %. Тест робили на моделі GPT-3.5 і пʼяти джерелах на запит, тому це напрям, а не закон для Google. Що ще входить у GEO-оптимізацію і як міряти її результат, розібрано окремо.
Відповідь у перших двох абзацах
Перші два абзаци мають повністю відповідати на запит із заголовка, так, щоб їх можна було процитувати без решти статті. Звичайний SEO-текст часто починається з розгону: чому тема важлива, кому стаття буде корисна, що в ній розібрано. Людина, яка сканує сторінку, і система, яка шукає речення під підзапит, отримують у цих рядках нуль фактів.
Умовний приклад для запиту «як порахувати CAC».
Було: «Кожен власник бізнесу рано чи пізно питає себе, скільки коштує йому один клієнт. Питання складніше, ніж здається, тож розберемо все по порядку».
Стало: «CAC це вартість залучення одного нового клієнта: витрати на маркетинг за період поділити на кількість нових клієнтів за той самий період. Умовний приклад: 75 000 грн бюджету за місяць і 220 нових клієнтів дають CAC 341 грн».
Друга версія містить визначення, формулу і розрахунок і відповідає одразу на головний запит і на підзапит «CAC формула».
Три правила для першого абзацу статті і для першого абзацу кожного H2:
- Називайте предмет прямо. «CAC це…», а не «він», «цей показник», «як ми писали вище». Займенник без попереднього речення нічого не означає.
- Спершу відповідь, потім умови. «Так, але тільки якщо…», «Залежить від одного: …». Умови без відповіді нічого не стверджують.
- Одна думка в абзаці. Абзац, де поруч стоять визначення, історія терміна і порада, важко процитувати частково.
Це не те саме, що нарізати текст на дрібні шматки. Google пише, що такої вимоги немає, а ідеальної довжини сторінки не існує. Стаття може бути довгою, важить порядок: відповідь угорі, розгортання нижче.
Як це позначається на показах, варто перевірити на власному сайті: у звіті Generative AI performance порівняйте покази переписаних сторінок за однакові періоди до і після зміни. Умовний приклад: 200 показів в AI Overviews і AI Mode за 28 днів до зміни і 260 за 28 днів після дають плюс 30 %, але якщо сторінки, яких ви не чіпали, за той самий час теж додали близько 30 %, зростання, найімовірніше, дав не текст, а загальні зміни в пошуку. Які з ваших ключових статей переписувати першими, а які не чіпати, можна розібрати на консультації для бізнесу.
Визначення і таблиці
Визначення у форматі «X це Y» окремим реченням і таблиця з конкретними значеннями дають готовий факт, який не треба переказувати. Список плюсів і мінусів без значень змушує і читача, і систему порівнювати самостійно, а таблиця вже порівняла за них.
Визначення пишіть так, щоб воно працювало поза статтею: термін, ширше поняття, відмінна ознака. «Retention це частка клієнтів, які купили повторно за обраний період» працює. «Retention це дуже важлива метрика для кожного бізнесу» не містить жодного факту.
Таблиця доречна там, де кілька варіантів порівнюються за однаковими ознаками. Робіть її текстом, а не картинкою: серед базових рекомендацій для AI-функцій Google називає важливий вміст у текстовій формі. Ось різниця між звичайним SEO-текстом і текстом, який цитують, по елементах статті:
| Елемент | Звичайний SEO-текст | Текст, який цитують |
|---|---|---|
| Початок | вступ про важливість теми | відповідь на запит за два абзаци |
| Термін | зʼявляється без пояснення | окреме речення «X це Y» |
| Порівняння | маркований список плюсів і мінусів | таблиця з однаковими ознаками і значеннями |
| Число | «вартість заявки 420 грн» | «420 грн: 21 000 грн бюджету поділити на 50 заявок за вересень» |
| Заголовок H2 | ключова фраза | питання або твердження, на яке розділ відповідає першим абзацом |
| Абзац | спирається на попередній («як сказано вище») | зрозумілий без сусідніх |
| Ключові слова | повтор варіацій запиту | природна мова і синоніми |
Щільність ключових слів тут не допомагає. Google пише, що його системи розуміють синоніми. У дослідженні GEO додавання ключових слів із запиту майже не змінило видимість, а в перевірці на Perplexity погіршило її на 10 %.
Числа з поясненням походження
Число з поясненням походження можна перевірити без вашої статті, тому поруч із ним пишіть, що на що поділили, за який період і звідки дані. «Вартість заявки 420 грн» це твердження, яке неможливо перевірити. «Вартість заявки 420 грн: 21 000 грн бюджету Google Ads за вересень поділити на 50 заявок із форми» це факт із формулою, і його можна повторити.
Серед питань для самоперевірки якості Google називає чітке зазначення джерел і відсутність фактичних помилок, які легко перевірити. Дослідження GEO дає лабораторне підтвердження: коли в текст додавали статистику, цитати і посилання на джерела, видимість у згенерованих відповідях зростала на 30–40 % за однією з двох метрик авторів. А от упевнений, «авторитетний» тон без нових фактів значущого ефекту не дав.
Що має бути поруч із кожним числом у статті:
- Формула або метод. Що на що поділили або як виміряли: «бюджет поділити на заявки», «опитування 900 людей».
- Період і обсяг. «За вересень», «за березень 2025 року». Без періоду число не можна порівняти з іншим.
- Джерело з роком. Назва дослідження прямо в реченні: якщо у відповідь потрапить одне речення, джерело має бути в ньому, а не в списку внизу.
- Позначка, якщо приклад умовний. «Умовний приклад» чесніший за правдоподібну вигадану цифру. AI-відповідь може процитувати вигадану цифру як факт, і поруч стоятиме назва вашого сайту.
Блок питань і відповідей
Блок питань і відповідей наприкінці статті корисний, коли питання взяті з реальних запитів, а кожна відповідь самодостатня і вміщується у два-чотири речення. Він закриває суміжні питання, які не заслуговують окремого розділу, і дає ще кілька фрагментів, придатних для цитування за підзапитами.
Розмітка FAQPage за три роки змінила роль. Із серпня 2023 року Google показував розширені результати FAQ лише для відомих авторитетних урядових і медичних сайтів, а з 7 травня 2026 року перестав показувати їх зовсім; документацію про цю функцію прибрали в червні 2026 року. Для AI Overviews і AI Mode структуровані дані не обовʼязкові, і спеціальної розмітки schema.org для них немає. Чи використовують FAQPage ChatGPT і Perplexity, у документації OpenAI і Perplexity не сказано. Тому пишіть блок для читача. Наявну розмітку можна лишити, бо невикористані структуровані дані, за словами Google, проблем не створюють; головне, щоб вона збігалася з видимим текстом.
Питання беріть із трьох джерел: запити у формі питань, за якими сторінка вже має покази в Search Console; блок «Люди також питають» у видачі; питання клієнтів у дзвінках і листах. Як збирати такі запити і групувати їх за сторінками, розібрано в статті про семантичне ядро. Формулюйте питання так, як його ставить людина, відповідь починайте з «так», «ні» або числа і не повторюйте дослівно сказане в розділах.
Що заважає цитуванню
Найчастіше цитуванню заважає не текст, а доступ: сторінка не в індексі, закрита для роботів або обмежена в сніпетах. Це варто перевірити до того, як переписувати статті, бо жодна формула першого абзацу не допоможе сторінці, якої система не бачить.
| Перешкода | Як перевірити | Що зробити |
|---|---|---|
| Сторінки немає в індексі Google | перевірка URL у Search Console | усунути причину і подати сторінку на індексацію |
| На сторінці noindex, nosnippet або обмеження max-snippet | код сторінки, перевірка URL | прибрати обмеження, якщо воно не навмисне |
| У Search Console сайт виключено з генеративних функцій | налаштування Search generative AI | повернути включення, якщо виключення не навмисне |
| robots.txt закриває OAI-SearchBot чи PerplexityBot | файл robots.txt сайту | дозволити цих роботів, якщо хочете бути у відповідях ChatGPT і Perplexity |
| CDN або firewall блокує AI-роботів | налаштування Cloudflare чи хостингу, логи сервера | дозволити потрібних роботів |
| Головний вміст лише на картинці або підвантажується тільки після кліку | HTML, який отримав Googlebot, у перевірці URL | перенести вміст у текст сторінки |
Рядок про CDN не теоретичний: 1 липня 2025 року Cloudflare оголосив, що за замовчуванням блокуватиме AI-краулерів, які не платять за контент, а Google окремо нагадує, що сканування має бути дозволене і в robots.txt, і на рівні CDN чи хостингу. OpenAI розділяє роботів для пошуку і для навчання моделей: можна дозволити OAI-SearchBot, потрібний для появи у відповідях ChatGPT, і закрити GPTBot, який збирає дані для навчання. PerplexityBot, за документацією Perplexity, для навчання моделей не використовується. Повний технічний прохід по сайту описаний у чеклісті технічного аудиту за годину.
На рівні тексту заважають три речі. Перша: переказ загальновідомого, який Google називає commodity content, з прикладом «7 порад для тих, хто вперше купує житло». Такий текст можна зібрати з будь-якого джерела або згенерувати, тому він нічого не додає до відповіді. Друга: відповідь, захована в середині розділу після двох абзаців контексту. Третя: дата, змінена без змін у тексті; Google окремо питає в самоперевірці, чи не оновлюєте ви дату лише для того, щоб сторінка здавалась свіжою.
Цей підхід не працює, коли сторінка слабка за звичайними мірками пошуку: генеративні функції Google спираються на ті самі системи ранжування, і структура не компенсує відсутність індексації чи довіри до сайту. Він мало дає для комерційних і локальних запитів, де людина шукає, де купити чи куди записатись: там важать сторінки послуг із цінами і профіль компанії в Google, а як будувати таку сторінку, розбирає стаття про тексти для сайту послуг. І він не приведе трафіку, якщо бізнес живе з переходів: цитування дає видимість, а не візит.
Часті помилки
Робити окрему сторінку під кожен підзапит. Google прямо називає створення контенту під кожну варіацію запиту чи підзапит fan-out заради маніпуляції порушенням політики щодо масового контенту (scaled content abuse). Одна сильна стаття, яка відповідає на підзапити розділами, краща за двадцять тонких сторінок.
Покладатися на llms.txt і спеціальну розмітку. Google Search ігнорує llms.txt: файл не шкодить і не допомагає. Вести його для інших систем можна, але не замість тексту. Спеціальної розмітки schema.org для AI-функцій Google теж немає.
Купувати згадки. Google пише, що неавтентичні згадки на сторонніх сайтах не такі корисні, як здається: основні системи ранжування орієнтуються на якісний вміст, а окремі системи блокують спам.
Вигадувати цифри для переконливості. Вигадане число, яке AI-відповідь процитувала з посиланням на вас, повертається до вас як репутаційна проблема, і виправити чужу відповідь ви не можете.
Міряти результат лише кліками. Покази в AI Overviews і AI Mode видно в окремому звіті Search Console, який з 31 серпня 2026 року доступний усім сайтам. Без нього ви не побачите, що статтю цитують, навіть коли кліки не ростуть.
Джерела
Джерела
- 01
- 02Google Search Central: AI features and your website (2025)developers.google.com
- 03
- 04Google Search Central: Creating helpful, reliable, people-first content (2025)developers.google.com
- 05Google Search Central Blog: Changes to HowTo and FAQ rich results (2023)developers.google.com
- 06Google Search Central: Latest documentation updates (2026)developers.google.com
- 07Google Search Console Help: Generative AI performance report (2026)support.google.com
- 08Google Search Console Help: Search generative AI control (2026)support.google.com
- 09OpenAI: Overview of OpenAI Crawlers (документація, 2026)developers.openai.com
- 10Perplexity: Perplexity Crawlers (документація, 2026)docs.perplexity.ai
- 11
- 12
- 13
FAQ
Питання й відповіді
- Чи треба писати окремі тексти під ChatGPT і окремо під Google?
- Ні. Google пише, що спеціально переписувати тексти під генеративний пошук не потрібно, а OpenAI і Perplexity у документації про своїх роботів говорять про доступ: дозволити пошукових роботів OAI-SearchBot і PerplexityBot. Одна стаття з відповіддю на початку, визначеннями, таблицями і числами з джерелами підходить для всіх трьох.
- Чи допомагає llms.txt потрапити в AI Overviews?
- Ні. У червні 2026 року Google окремо уточнив, що Google Search не використовує llms.txt: файл не шкодить і не допомагає. Інші сервіси можуть його читати, тому вести його можна, але це не заміна індексації і доброго тексту.
- Чи потрібна розмітка FAQPage?
- Для Google вона більше не дає видимого ефекту: розширені результати FAQ з 7 травня 2026 року не показуються. Для AI Overviews і AI Mode спеціальна розмітка не потрібна. Якщо розмітка вже є, прибирати її не обовʼязково, головне, щоб вона збігалась із видимим текстом.
- Як дізнатися, чи цитують мій сайт в AI Overviews?
- У Search Console є звіт Generative AI performance: він показує покази посилань на ваш сайт в AI Overviews і AI Mode за сторінками, країнами і пристроями. З 31 серпня 2026 року його відкрили для всіх сайтів, але якщо показів замало, звіт може не зʼявитись.
- Чи може новий сайт потрапити в AI-відповіді?
- Може, якщо сторінка індексується, може показуватись зі сніпетом і сайт не виключений із генеративних функцій у Search Console (за замовчуванням він включений). Але генеративні функції спираються на ті самі системи ранжування, тому сайт без позицій і довіри цитуватимуть рідко, хоч як добре структурований текст.
Перелінковка
Де ще про це йдеться
- GEO-оптимізація: що це, чим відрізняється від SEO і як потрапити у відповіді ChatGPT і GoogleСайт і SEO
- Контент-маркетинг: що це, чим відрізняється від реклами і SMM, які формати приводять клієнтів і як запустити його за 90 днівСайт і SEO
- Реклама в ChatGPT: як працює, скільки коштує і чи можна запустити її з УкраїниРинок і платформи — що змінюється і чому
- Як користуватись Google Search Console: три звіти за 40 хвилин, з яких видно, що писати даліСайт і SEO